 下载格隆汇APP
 下载诊股宝App
 下载汇路演APP

 社区
 会员

企业 AI 智能体每天都在做大量判断:这条消息是投诉还是咨询?这段检索内容跟用户问题相关吗?该用哪个模型来处理?
这些判断不需要生成文字,只需要一个答案——是/否、A/B、相关/不相关。但大多数平台还在用完整的大语言模型来完成:生成几百个 token,只为了得出一个分类结果。
结果就是:为不需要的文字买单,为几毫秒的判断等上几秒,而且永远不知道模型到底有多确定。
当 AI 只需要「判断」,不需要「思考」
9月15日,TypeSafe AI 发布了 Jev——一个专为判断而生的"System One"模型。它不生成文字,只返回结构化的概率决策:选择、评分、或是/否,每个答案都带有校准后的置信度分数。
发布一周内,Jev 已被 Vercel、Cloudflare、LangChain 等主流开发者平台集成,成为近期 AI 基础设施领域最受关注的模型发布之一。
根据 TypeSafe 公布的基准测试数据:
速度
70–500ms 端到端响应,对比大语言模型的 3–329 秒。
成本
输入 0.042 美元/百万 Token,输出免费——比大模型判断任务便宜最高 445 倍。
可靠性
结构化输出错误率 0%,部分大模型高达 45.5%。
GPTBots.ai 的两层架构:一层思考,一层判断
GPTBots.ai 并不是在已有系统上「外挂」了一个 Jev。平台本身就运行着多个决策层机制——模型自动路由、知识文档动态 Top-K、FlowAgent 和 Workflow 的意图分类器。这次集成,是把这些能力统一到 Jev 这个专用决策引擎下。
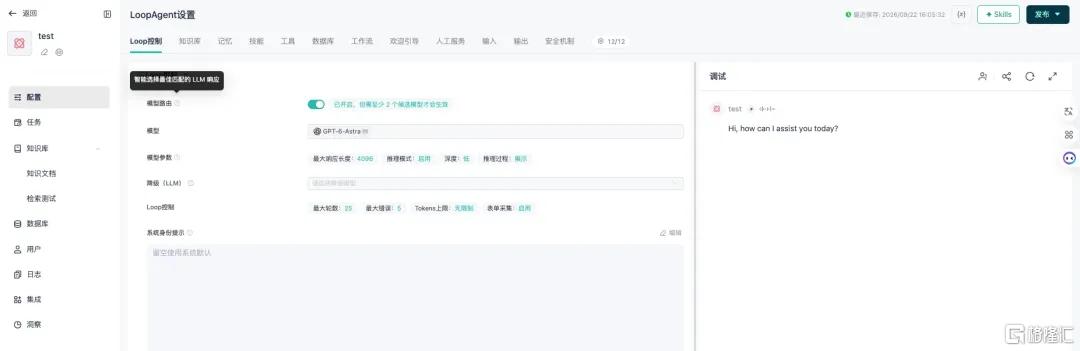
1、模型自动路由:每个任务开始前,GPTBots.ai 会评估传入的问题并匹配最佳模型。Jev 让这个路由决策从一次完整的大模型调用,压缩到 500ms 以内的判断,成本降至万分之一美分级别。
2、知识文档动态 Top-K:RAG 检索出的几十个文档切片中,不是每个都跟问题相关。Jev 对每个切片打分,过滤掉不相关内容后再交给大模型——减少幻觉风险,节省 token 消耗。
3、FlowAgent 和 Workflow 意图分类:分类器识别用户意图后,将对话路由到正确的业务分支。Jev 为每个路由决策附带置信度分数:高置信度自动执行,不确定的升级到大模型或人工。
“ 模型路由、动态检索、意图分类——这些构建块我们本来就有。Jev 给我们的,是一个专用决策引擎,用全新的速度和成本来处理这些判断。以前每次路由决策都要付一次完整的大模型调用费,现在每个判断只花不到一美分——还附带校准后的置信度分数。”
—— 罗伟东,GPTBots.ai 创始人兼 CEO
置信度驱动的执行:自动、复核、升级
两层架构引入了可配置的置信度阈值机制。每个 Jev 决策都带有概率分数,企业可以按工作流自行设定阈值——哪些决策高置信度自动执行,哪些需要复核后再行动,哪些必须升级给真人。
计费分类可以设定在高置信度时自动执行;合规决策可能需要接近确定的结果才放行。平台适配的是「犯错的成本」,而不只是「做对的速度」。
对企业客户意味着什么
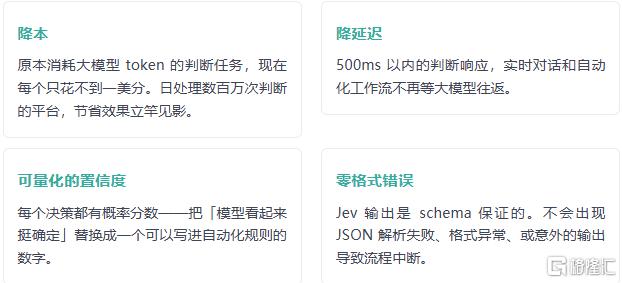
当判断的成本趋近于零,AI 智能体的竞争焦点会从"谁更聪明"转向"谁做对更多次"。聪明一次不贵,但每天做对一百万次——这才是真正难的事。