 下载格隆汇APP
 下载诊股宝App
 下载汇路演APP

 社区
 会员

大模型行业的竞争范式正在转变。随着Agent深度嵌入企业业务流程,模型调用频率指数级攀升,算力成本与投入产出效率成为核心竞争维度,全球头部厂商几乎走向同一条战略路径:
谷歌迭代Gemini Flash系列模型,将3.8 Flash打造为兼顾性能、速度和成本的主力工作模型。云知声、智谱以及DeepSeek也做出同样的技术选择,U2-Flash、GLM 5.3 Flash、DS V4.1 Flash都是这条技术方向演进的成果。
9月15日,云知声发布新模型U2-Flash,定位为面向真实任务的新一代高性能主力模型,总参数约266B,单次推理仅激活约10B,激活比例不到总参数的4%,Flash已升级成“能干活的主力智能”。
对长期深耕产业AI的云知声而言,U2-Flash是U2高智能密度路线的延续,更是公司撬动高频调用市场、推动收入结构升级的关键落子。
从U2到U2-Flash,面向真实执行的能力与效率进化
先看U2奠定的技术底色。今年6月,云知声发布通用基座模型U2,跳出参数堆叠路径:2600亿参数规模达到主流万亿级模型性能,Token成本降至稠密模型的十分之一。
U2贯彻了云知声的价值主张:AI公司行业价值=智能密度×Token价值。凭借更少激活资源承载更强能力,U2在长上下文理解、知识推理、指令遵循、智能体执行及复杂任务等主流评测中跻身全球第一梯队,验证了高智能密度的竞争力。
但Agent落地进入深水区后,新矛盾凸显:Token消耗不是“对话量”的线性增长,而是“任务复杂度×执行时长”的指数级攀升。一个典型项目的Token消耗量可达百万级,比普通对话单次千级消耗,提升了三个数量级。
因此让复杂任务“用得起、用得频”,成为大模型规模化落地的新卡点,U2-Flash正是针对这一卡点给出的解答。
作为基于U2强化后训练的产物,U2-Flash在U2基础上实现推理、Agent执行与复杂任务能力全面升级,同时实现了更快的响应速度与更低的调用成本。
在能力方面,升级锚定真实生产力场景,覆盖工程代码、终端任务、办公处理、知识推理、指令遵循等核心环节。公开评测数据显示,SWE-Bench Pro得分61.6,较前代提升10.5分;DeepSWE v1.1得分64.6,较前代U2的32翻倍;TerminalBench 3.0得分24.3,较前代的2.7分显著提升;在WorkBuddy-Bench Office办公场景评测中得分81,高于DeepSeek V4 Flash、DeepSeek V4 Pro和GLM 5.2。
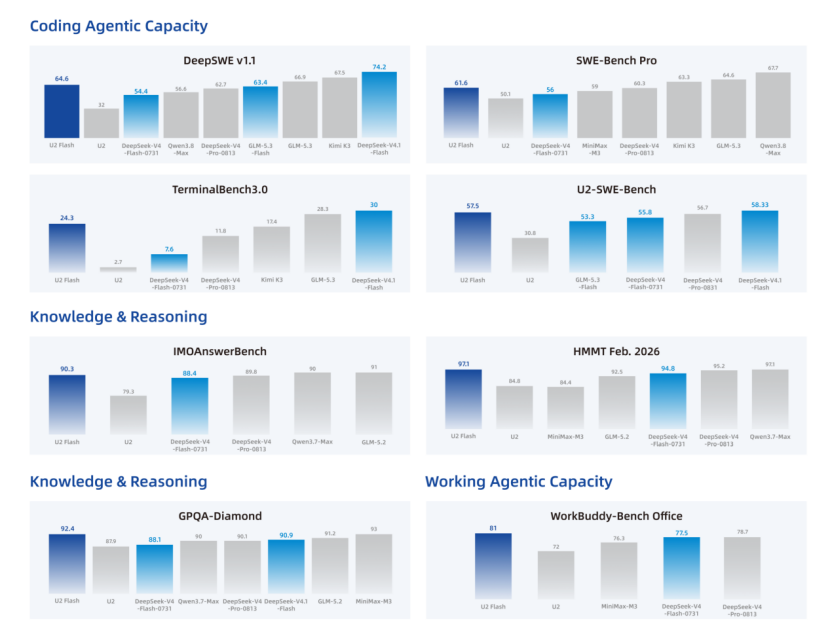
在速度方面,模型首字响应时间平均控制在3秒以内,峰值输出速度300 Tokens/s;对比U2模型,U2-Flash在Agent任务执行过程中减少20%-30%的迭代步数,任务执行周期缩短35%。可见U2-Flash做到了更快响应、更快生成、更快完成,算力更多投向解决问题本身,最终体现为每一个Token都承载更高的有效信息密度。
从行业视角看,U2-Flash在“能力-成本”曲线上确立了更优坐标:以远低于同能力级模型的Token消耗,维持第一梯队的复杂任务执行能力。其商业价值不在“绝对最强”,而在“最具性价比的强”。
更重要的是,U2-Flash将重构Token生态的供需格局。需求端,模型具备高频调用的经济基础,成为可规模化落地的智能基础设施,哪怕一次文档整理、一轮代码修改、每天的资料更新,都可能成为稳定发生的调用。
供给端,一方面,U2-Flash在同等算力下可输出更多有效Token;另一方面,U2-Flash围绕主流国产算力平台完成从架构到调度的全栈适配,软硬件协同调优后,国产平台的吞吐、时延、并发与集群扩展能力持续提升,与主流GPU差距持续收窄,部分场景接近NVIDIA GPU表现。单卡提效与多元算力接入共同释放供给弹性,为高频调用时代筑牢了产能底座。
撬动高频调用市场,Token业务的增长空间与估值重构
技术进化最终要回答一个核心商业命题:能否转化为收入结构的质变。
过去两年,中国市场日均Token调用量暴增超千倍,2025年底达百万亿级,但同年公有云MaaS(模型及服务)营收仅停留在30亿元量级,海量需求并未转化为对等的账面收入。
云知声Token业务则实现爆发式增长:上半年收入近3000万元,同比激增760%,二季度环比增长超过500%,毛利率超过60%。这是公司增长最快的板块,但占总营收比重仅约5%,处于爆发初期。同时,上半年客户复购收入占比超过60%,客单价也在显著提升。
这表明云知声“强基模”能力已有效传导至应用层,模型被越来越多客户高频调用,真正进入了客户核心工作流并形成粘性,Token商业模式的价值潜力加速兑现。
U2-Flash的推出,有望进一步推动Token业务放量。这背后是科技产业反复验证的规律:当技术的单位使用成本降到某个阈值,使用门槛大幅降低,需求就会呈非线性释放。云计算如此,半导体如此,大模型API也不会例外。
从U2到U2-Flash,云知声凭借模型更快响应、更高生成速度和更短的Agent任务完成时间,正在把这一规律推向现实。成本下降驱动调用量扩张,调用量扩张又进一步摊薄部署成本,形成正向飞轮。
U2-Flash更深层的差异化壁垒,在于云知声长期坚持的产业深耕路线,与Palantir异曲同工。模型能力再强,也需要扎根业务逻辑做分析推理;缺乏场景深度理解,输出的结论看似自洽,落地往往水土不服,难以转化为真实的业务价值。
Palantir的AIP(人工智能平台)之所以成功,核心正是用“本体论”为AI构建认知框架,用知识图谱为推理提供语义支撑,用规则引擎确保逻辑一致性。这一战略带来了业绩爆发:2026年Q2营收约19.4亿美元,同比增长93%,归母净利润10.62亿美元,同比增长225%。
云知声在医疗、保险、交通、工业等场景十余年的落地积累,沉淀了深厚的行业know-how。这让U2-Flash从诞生起就不是悬浮的技术标杆,而是扎根真实场景的生产力工具。这种“从业务中来,到业务中去”的模型,进入企业可以直接创造价值,更容易形成高留存、高复购的客户关系。
这带来的不只是收入增长,更是公司估值逻辑的重构。Token业务本质上是平台型收入——按量计费、可复用、高毛利,客户的AI使用强度直接决定收入弹性。随着U2-Flash带动高频调用持续放量,云知声的收入结构将逐步从“一次性项目交付”转向“持续性调用收费”,估值锚点也自然向平台型AI公司迁移。
结语:
中国大模型在调用量上的优势能否转化为收入红利,核心取决于计价方式向Token迁移的速度,以及垂直场景的变现能力。从这个意义上说,谁能把智能的使用门槛降到足够低、让更多场景实现高频调用,谁就能吃到规模化落地的红利。
U2-Flash的发布,是云知声在这条路上的关键一跃——它把U2验证过的高智能密度优势,转化为面向高频调用的商业化动能,推动收入结构加速向持续调用服务升级。云知声的技术底子已经夯实,接下来的核心看点,是Token业务增长能否延续上半年的陡峭斜率。这既是云知声自身价值重估的试金石,也是观察中国大模型厂商差异化突围的重要样本。